
统一纳管,模型 Day-1 快速上线
开放架构统一纳管物理机、虚拟化、容器等多种环境下的异构算力,屏蔽底层差异,对各类模型集中管理;平台 1 天完成部署、模型 Day-1 快速上线。
面向企业 AI 应用从验证走向生产,榫卯 AI 平台帮助用户在统一基础设施上完成算力管理、模型部署、调用治理与持续运维,加快 AI 能力接入业务场景。
GPU inventory by model
| Model | Total | Free |
|---|---|---|
| NVIDIA L20 | 2 | 1 |
| Tesla T4 | 2 | 1 |
Cluster utilization
榫卯 AI 平台是一款面向企业 AI 推理与模型服务场景 的基础设施平台,支持在本地环境中统一管理异构算力资源、多类型模型资产和模型调用入口,帮助企业更安全、高效地构建可管理、可治理、可观测的 AI 服务底座。
平台采用灵活兼容的架构,可适配物理机、虚拟机、Kubernetes 等多种运行环境,以及 NVIDIA、昇腾、AMD、Intel 等多类 AI 芯片。通过模型仓库、推理引擎、模型网关、资源调度、权限治理和可观测能力,榫卯 AI 平台帮助企业降低模型部署与算力管理复杂度,加快 AI 应用从验证走向生产。
开放架构统一纳管物理机、虚拟化、容器等多种环境下的异构算力,屏蔽底层差异,对各类模型集中管理;平台 1 天完成部署、模型 Day-1 快速上线。
平台灵活开放,支持部署在任意位置、兼容各类工作负载,可充分复用已有基础设施、减少重复投入;模型统一供给,可充分复用;结合 GPU 虚拟化与按显存/算力粒度切分,让 GPU 资源更精细、更高效地使用。
平台原生内置模型网关,统一提供用量统计、Tokens 配额、调用日志与访问控制,让模型使用可见、可控、可审计、可量化运营。
推理服务支持多副本高可用、负载均衡与原生 KV Cache offloading,依托生产级容器与存储底座、统一监控与日志体系,提供轻量、稳定、可观测的生产级推理服务,保障业务持续稳定运行。
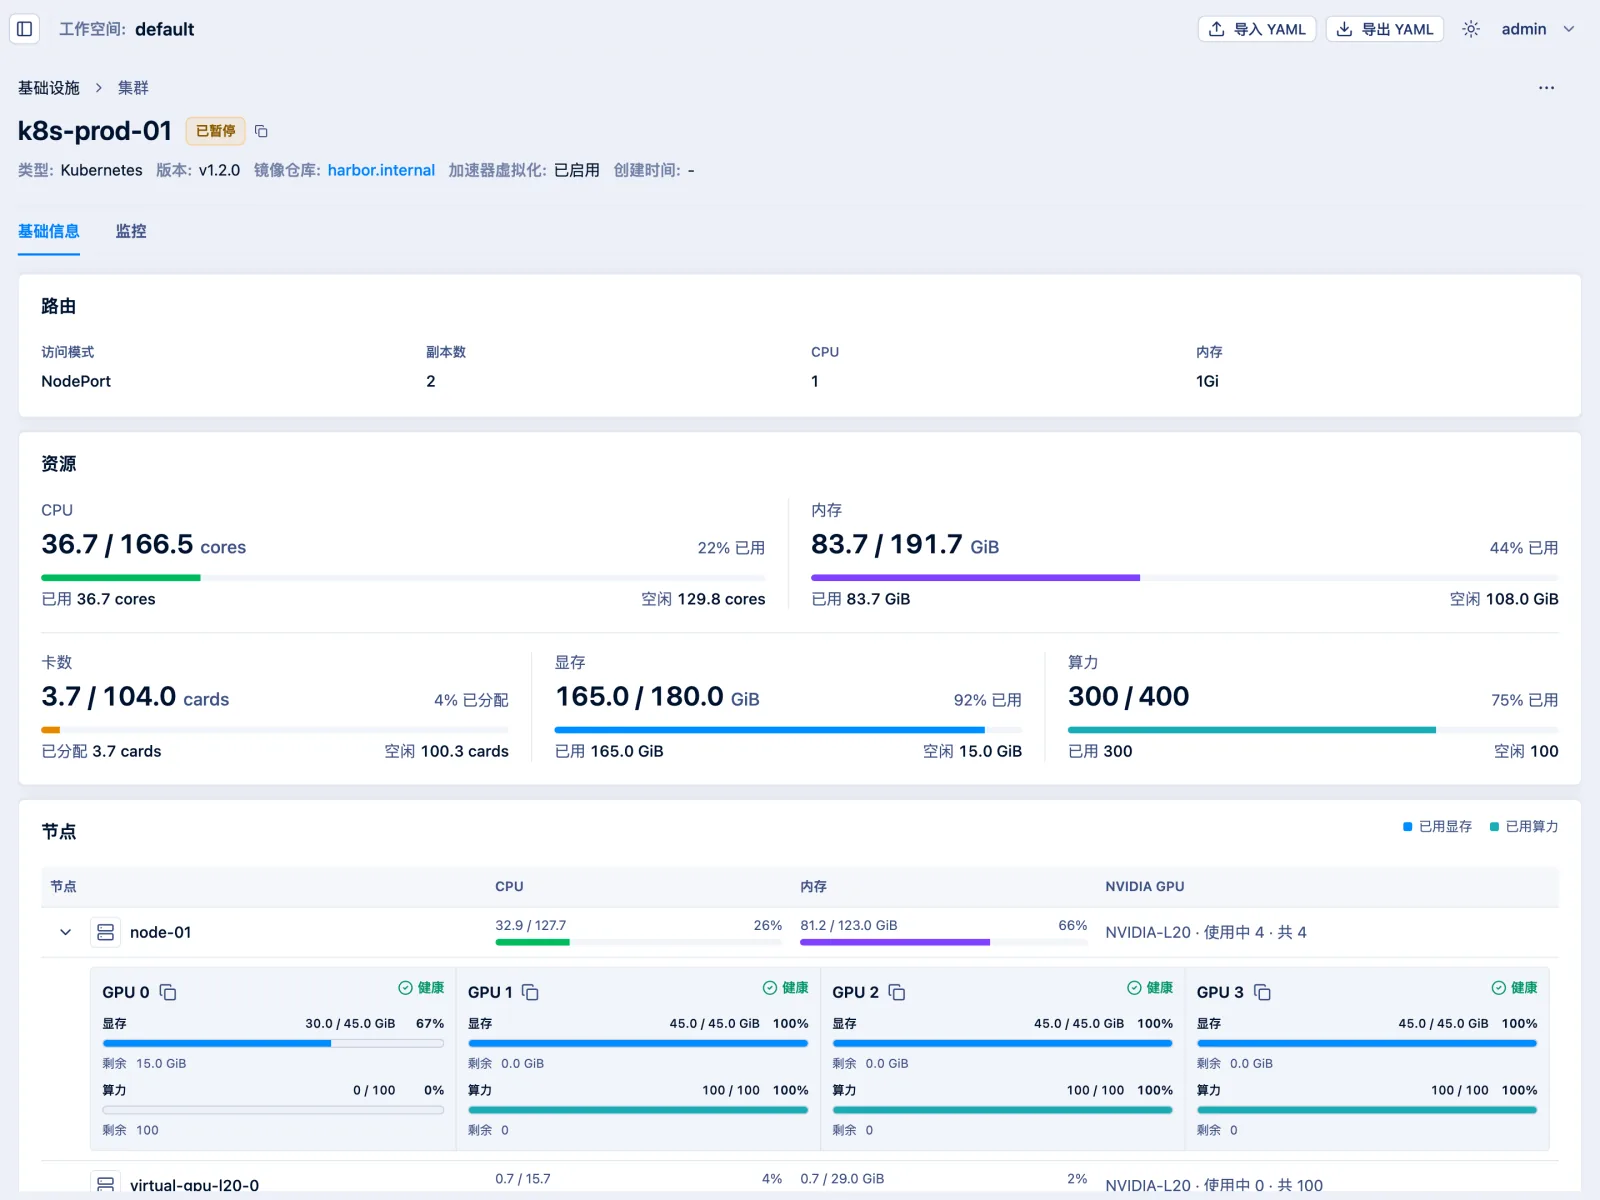
支持将物理机、虚拟机和 Kubernetes 集群中的 AI 算力统一纳入平台管理,屏蔽底层环境差异,实现资源统一调度、监控与分配。
支持 NVIDIA、昇腾、AMD、Intel 等异构 AI 芯片,覆盖 GPU、NPU 等多类算力资源。平台可统一纳管企业已有和新建算力资源,帮助减少重复建设,提升基础设施复用率,同时满足国产化和异构算力建设需求。
支持 NVIDIA GPU、昇腾 NPU 等异构算力资源的动态切分与整卡直通,可根据模型规模与性能需求灵活分配显存和算力:大模型推理采用整卡直通,保障性能与吞吐稳定;OCR、ASR、Embedding、Rerank 等轻量模型通过资源切分共享算力,在同一平台兼顾性能、资源利用率与成本控制。
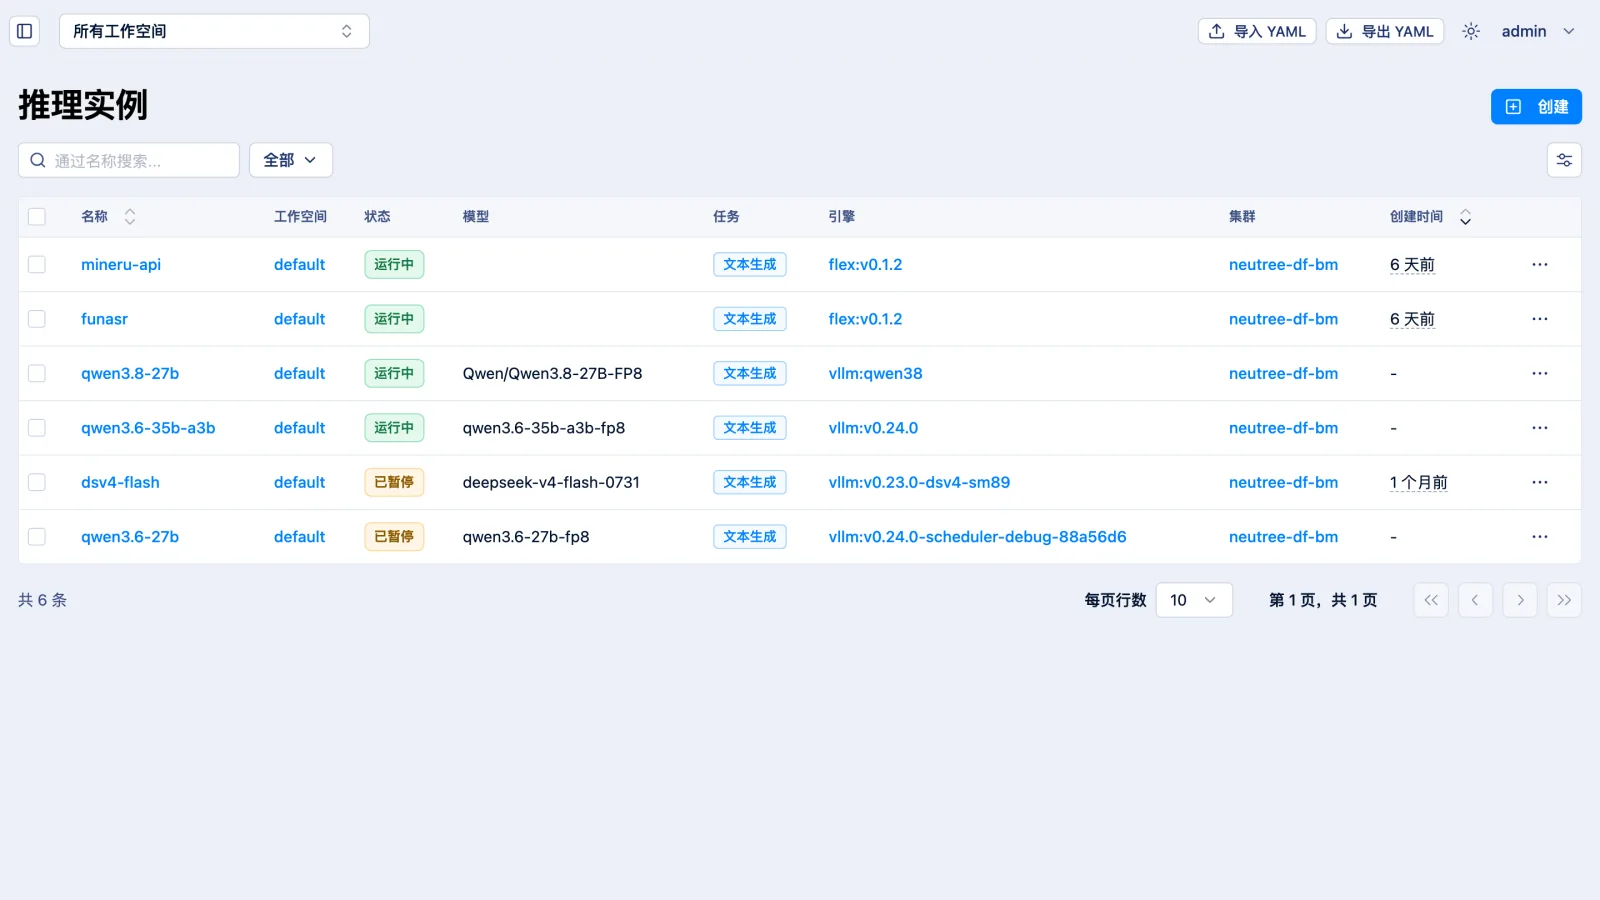
支持大语言模型、多模态模型、Embedding、Rerank、视觉模型等统一管理,并通过 Flex Engine 扩展支持 MinerU、PaddleOCR 及部分机器学习模型,在同一平台完成语言、视觉、文档解析、OCR 和机器学习模型等多类模型资产的部署、发布和调用。
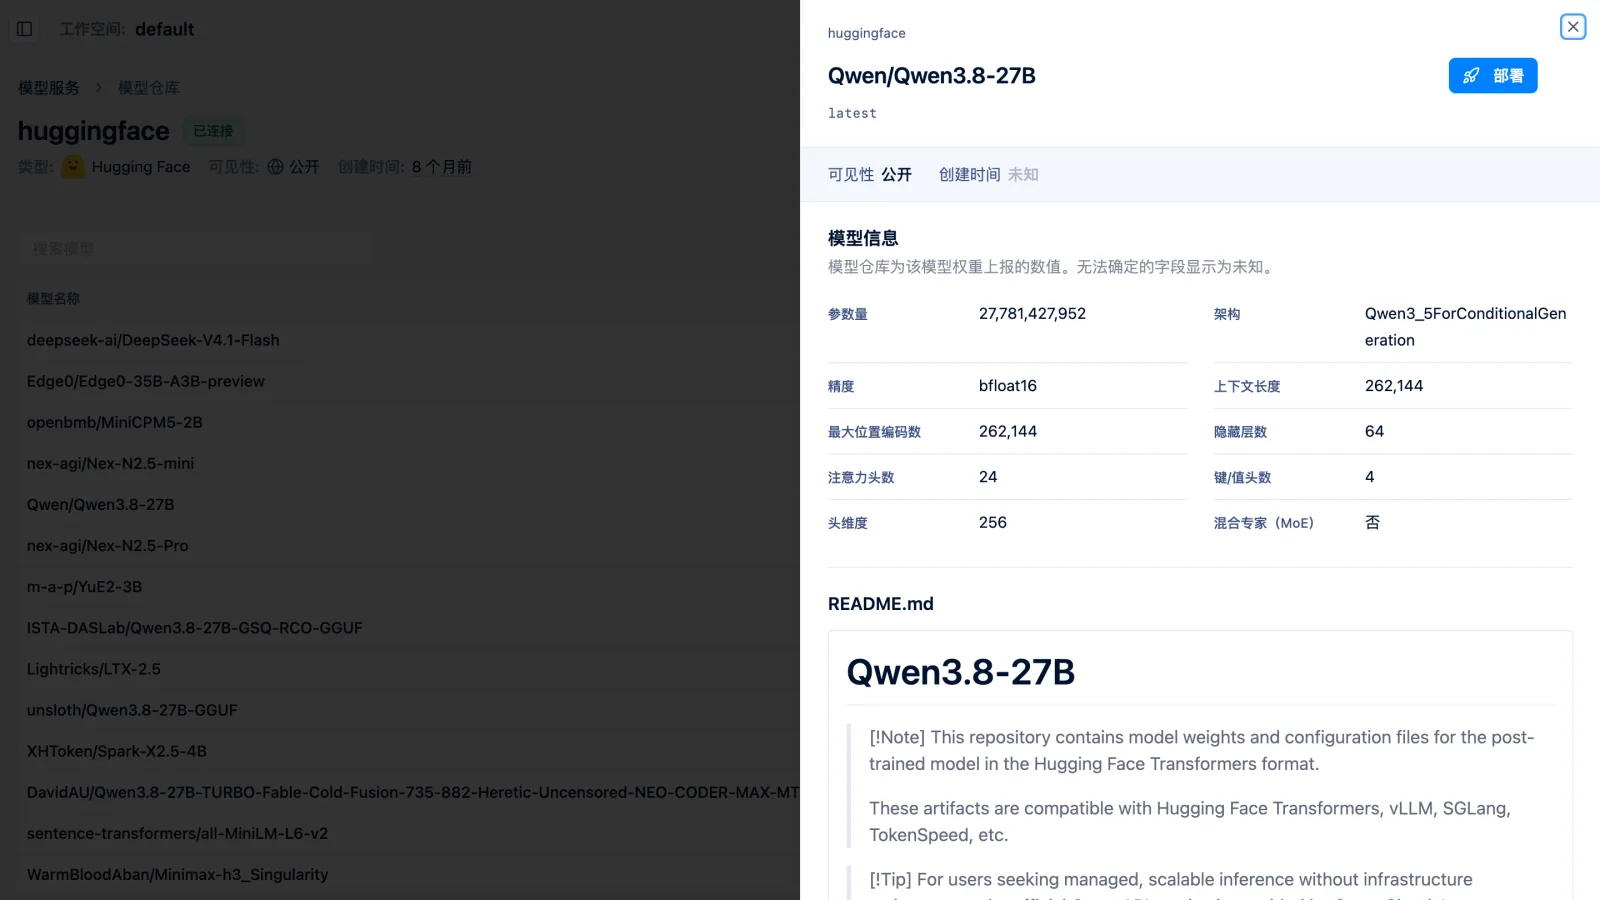
统一管理公有与私有模型仓库,集中展示模型来源、连接状态、可见性、模型数量、存储占用和更新时间等信息。单一模型详情页可展示参数量、大小、精度、上下文长度等关键属性,降低部署前的信息确认成本。
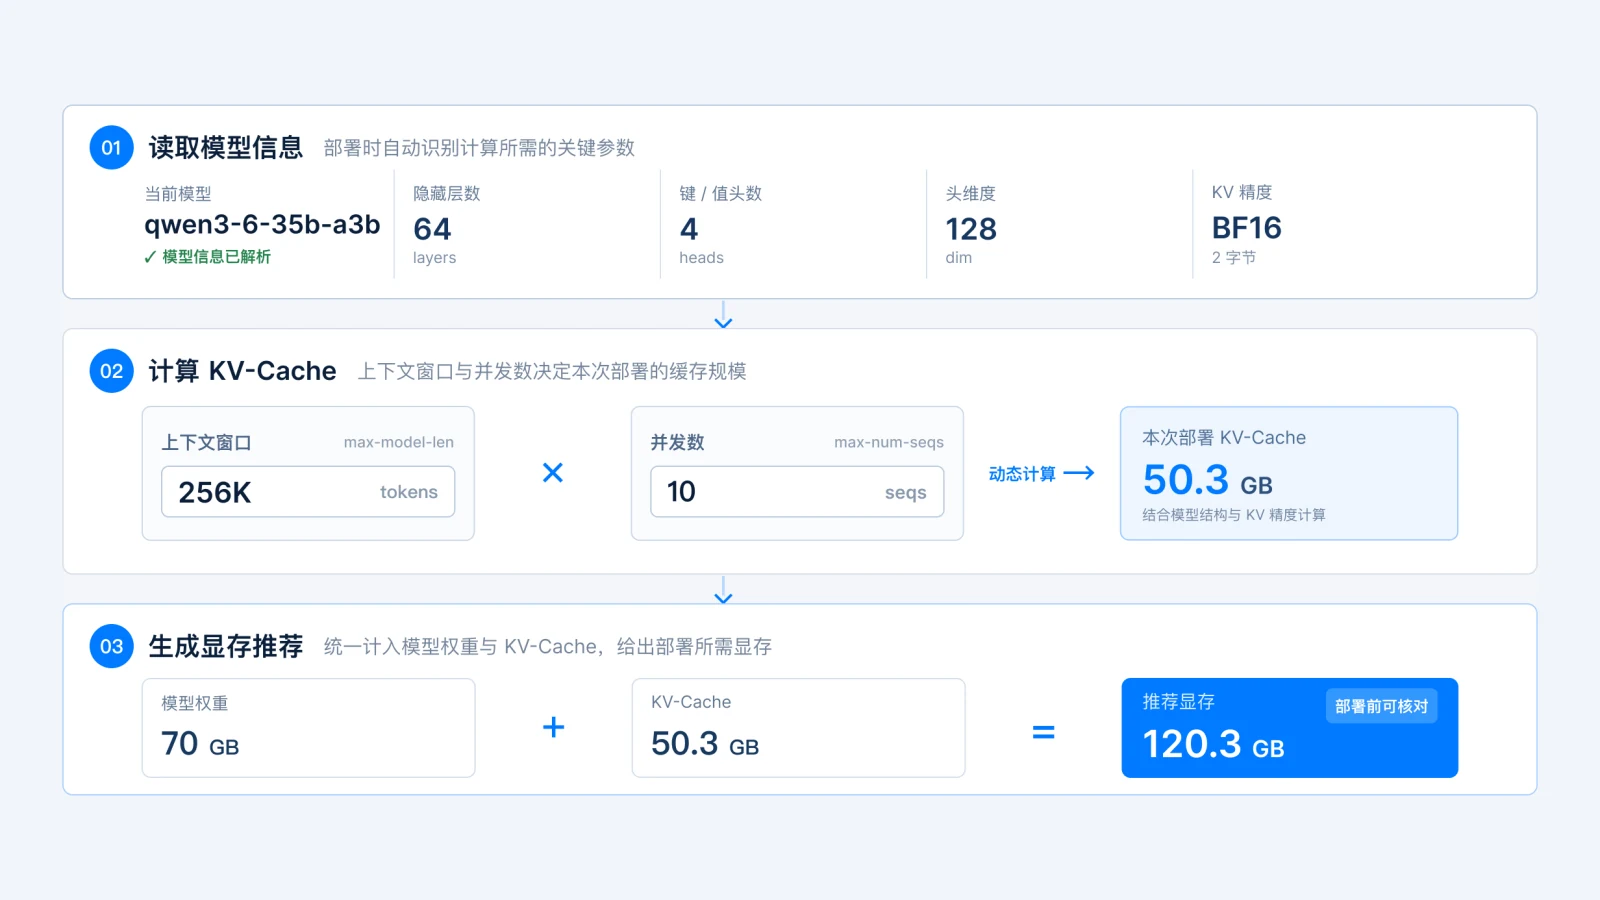
部署模型时自动解析模型结构,并结合上下文长度、并发数等参数动态计算 KV Cache 与显存需求,将模型权重与 KV Cache 统一计入推荐显存,帮助提前评估资源配置,降低因资源不足导致的部署失败风险,并减少过度预留带来的显存浪费。
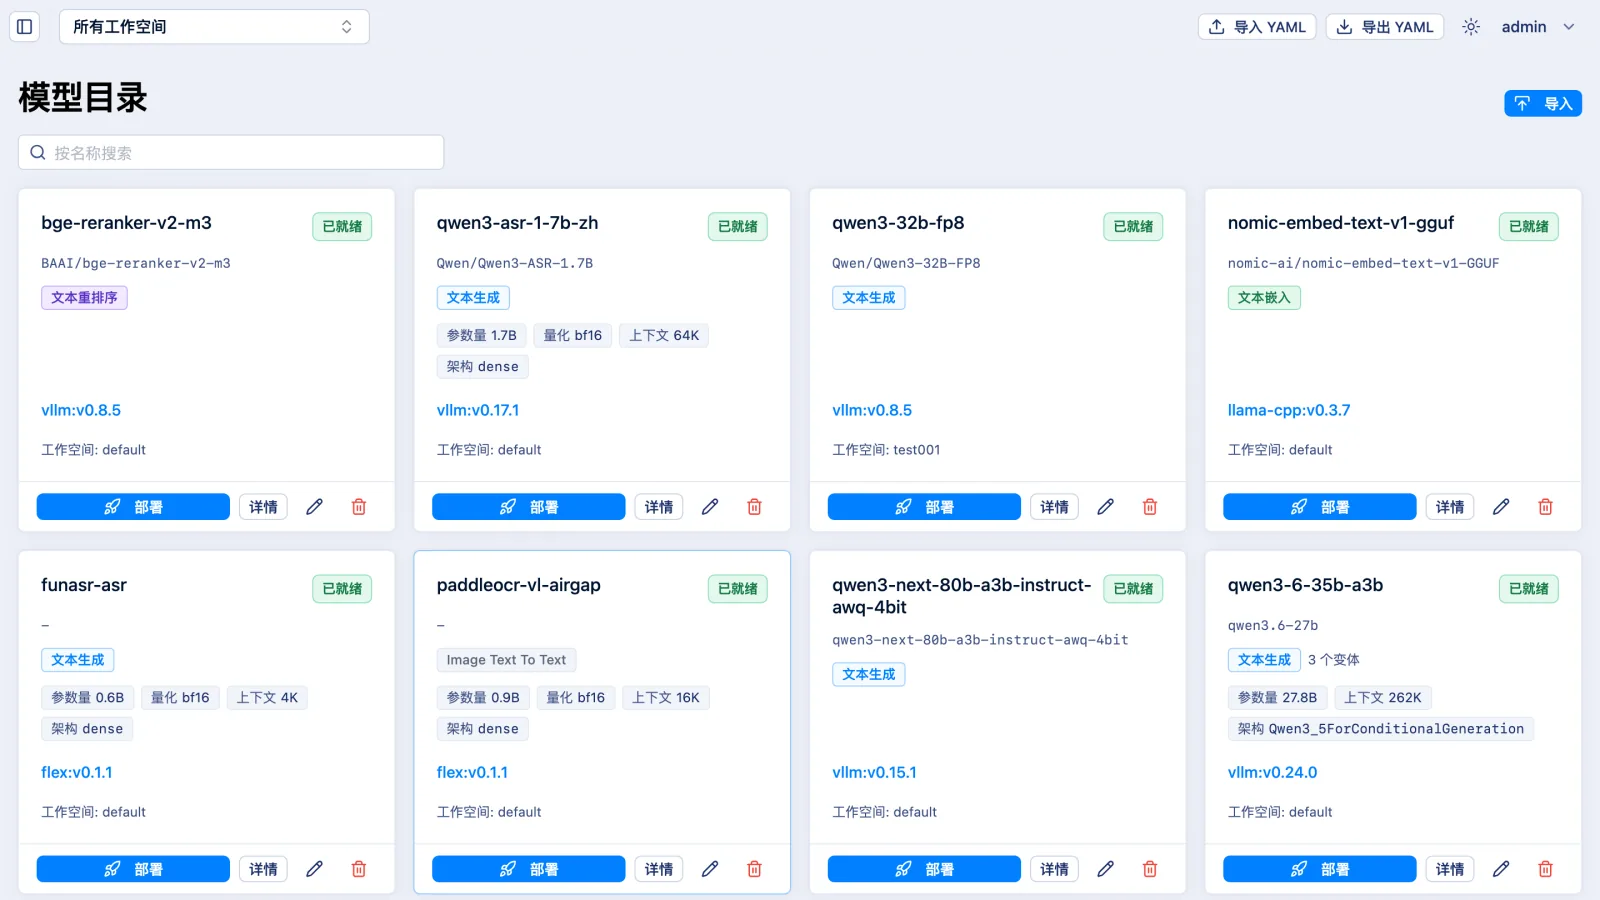
通过模型 Catalog / 模型模板沉淀推理引擎、任务类型和推荐参数,支持主流模型的快速部署、验证和发布,减少重复适配、参数配置和人工验证工作。
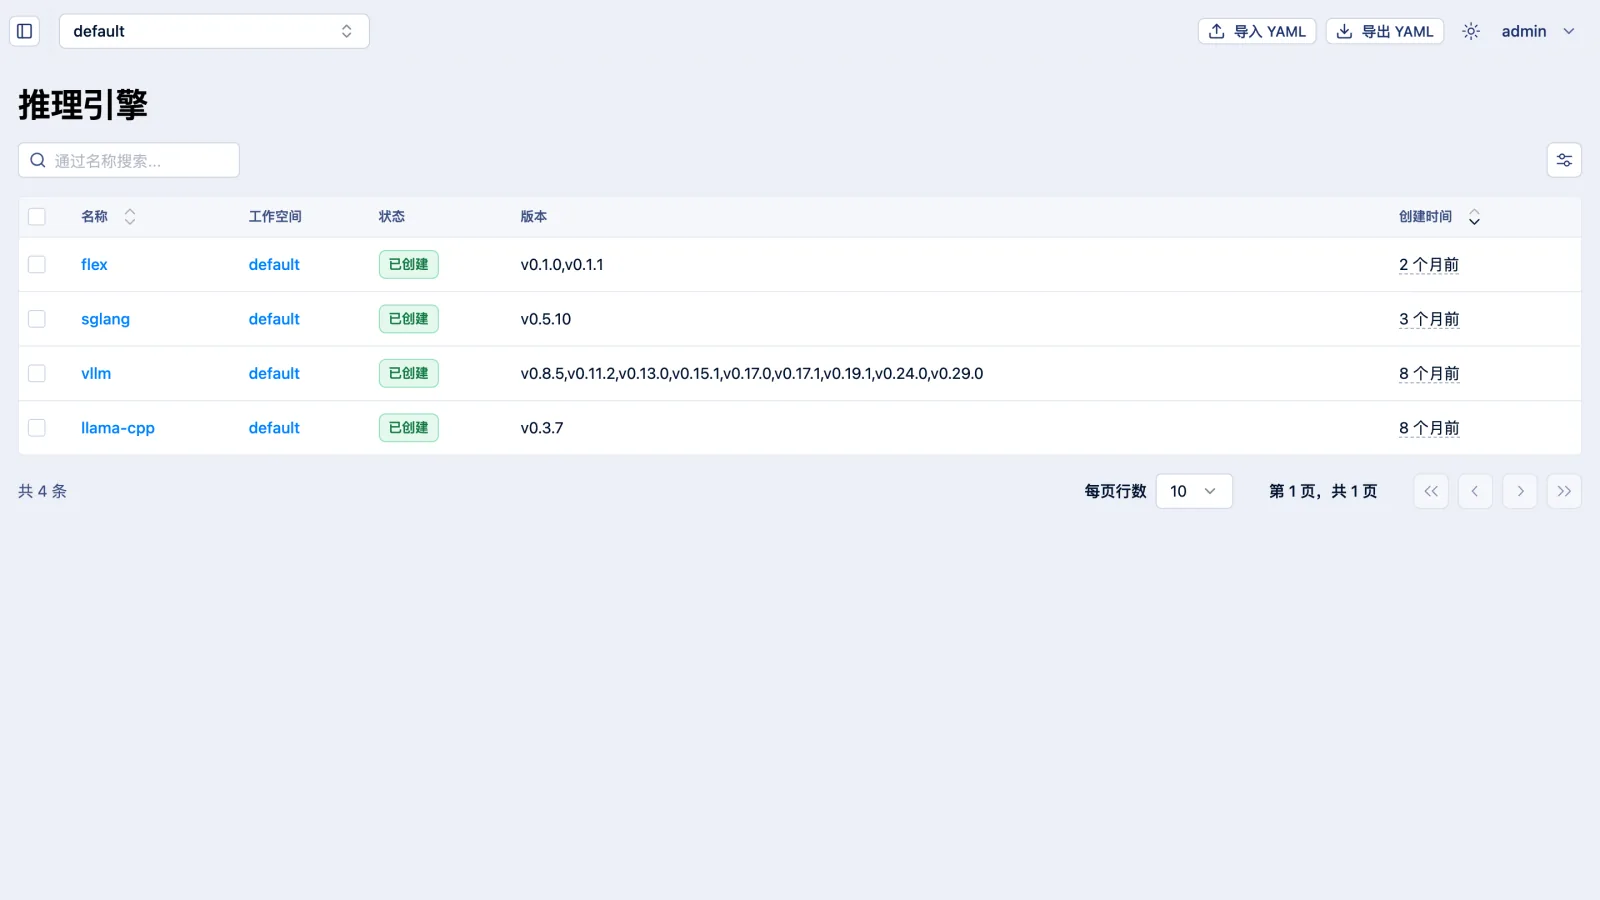
支持主流推理引擎及其多版本统一管理,可在生产运行与新模型验证场景中灵活选择合适的推理引擎版本,在保障生产稳定性的同时,提升新模型适配和验证效率。
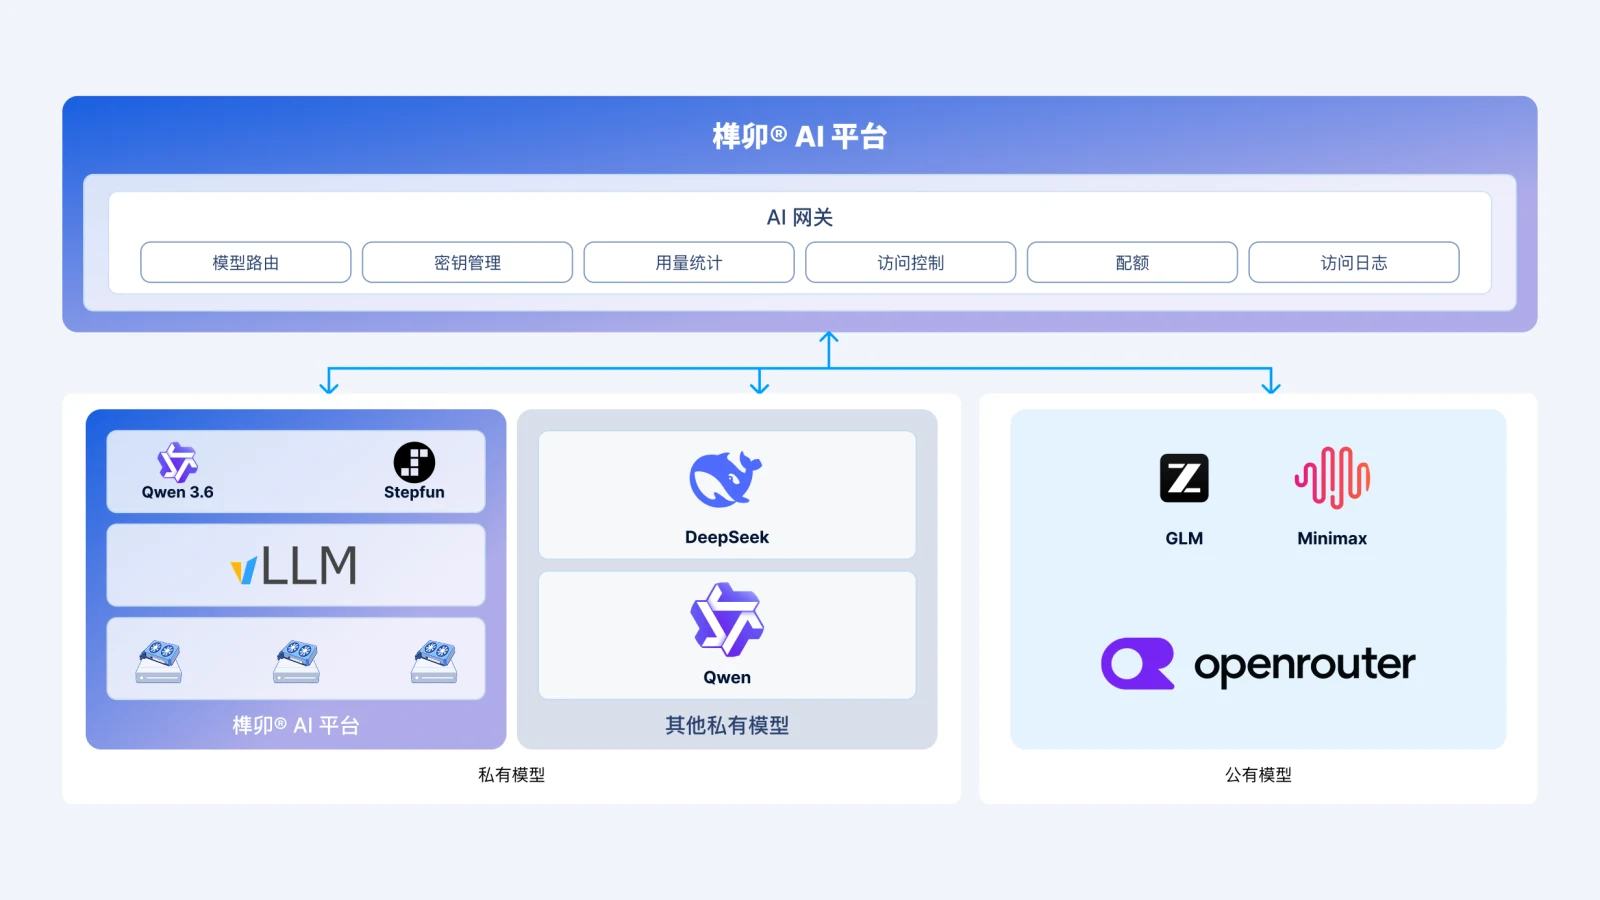
通过统一模型网关接入私有模型、公有模型和其他外部模型 API,为不同业务应用提供一致的模型调用入口。应用侧可通过统一接口调用不同模型,减少因模型变更带来的调用地址、鉴权方式和接入配置调整。
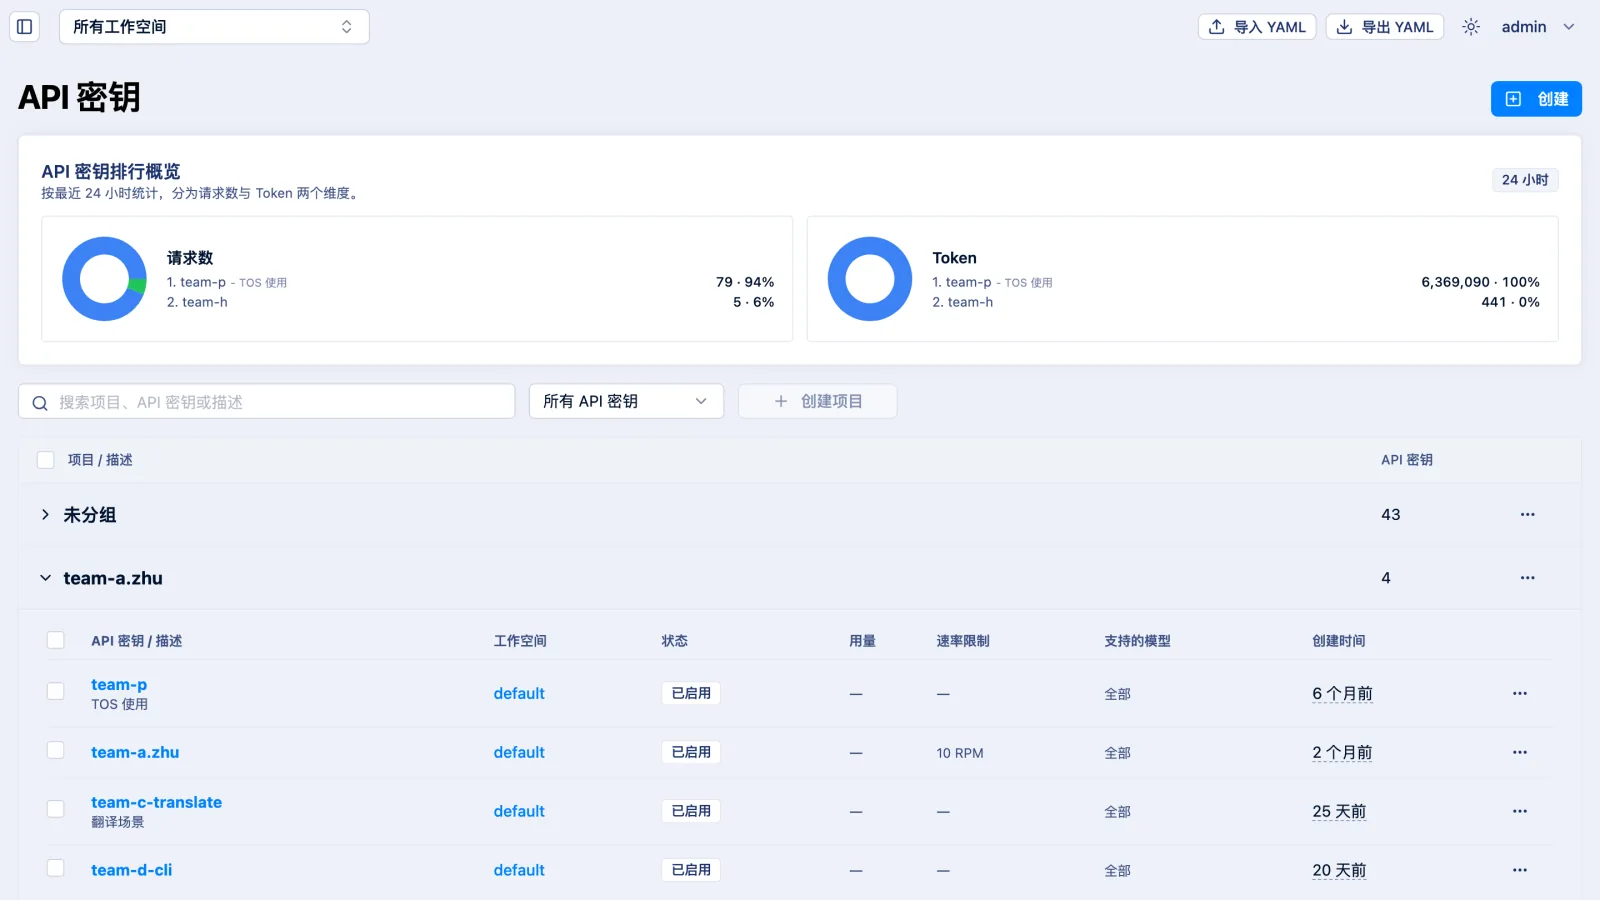
集中管理模型调用密钥,并支持按 Project 分组识别业务归属。管理员可围绕业务项目聚合多个 APIKey,在统一界面查看工作空间、状态、用量、速率限制、支持模型和创建时间,提升多业务场景下的密钥管理效率。
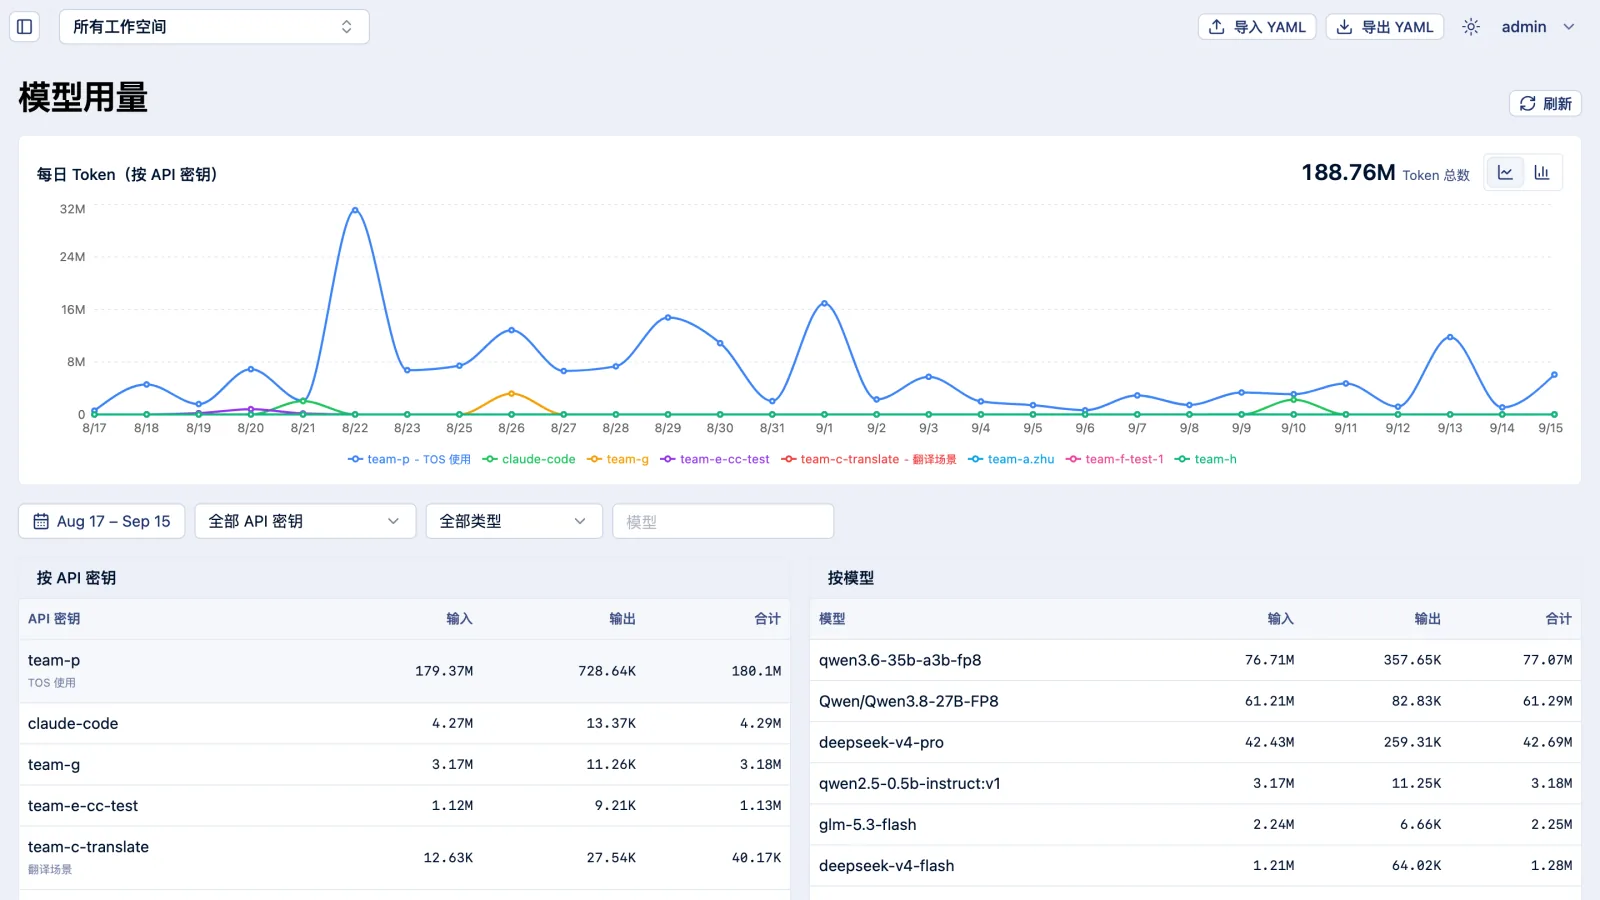
支持按 APIKey、模型等维度统计 Tokens 用量和请求情况,呈现不同业务与模型的资源消耗分布,为资源规划、成本核算和服务优化提供依据。支持为 APIKey 设置 Tokens 用量配额,帮助企业按业务需求精细分配模型服务资源。
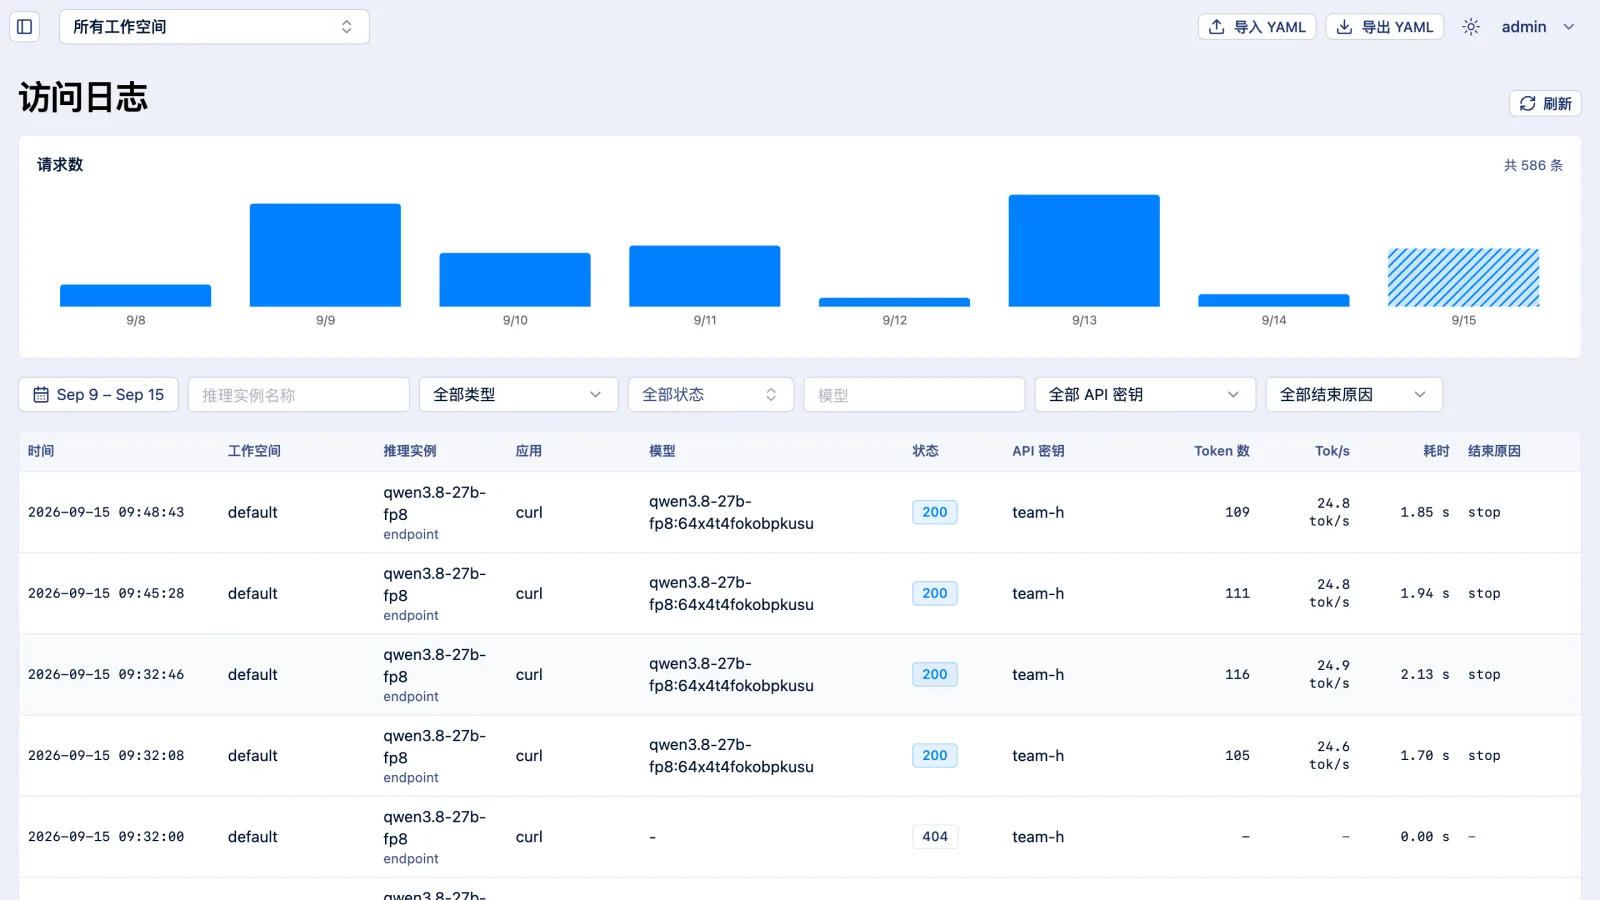
支持对 APIKey 设置请求限速、并发上限和可访问模型范围,帮助企业落实最小权限原则,减少资源滥用和越权调用风险。同时,平台可按请求粒度记录访问来源、调用密钥、调用模型、请求状态、Tokens 消耗、吞吐、耗时以及结束原因,并支持留存请求 / 响应明细,便于问题定位、性能分析和安全审计。
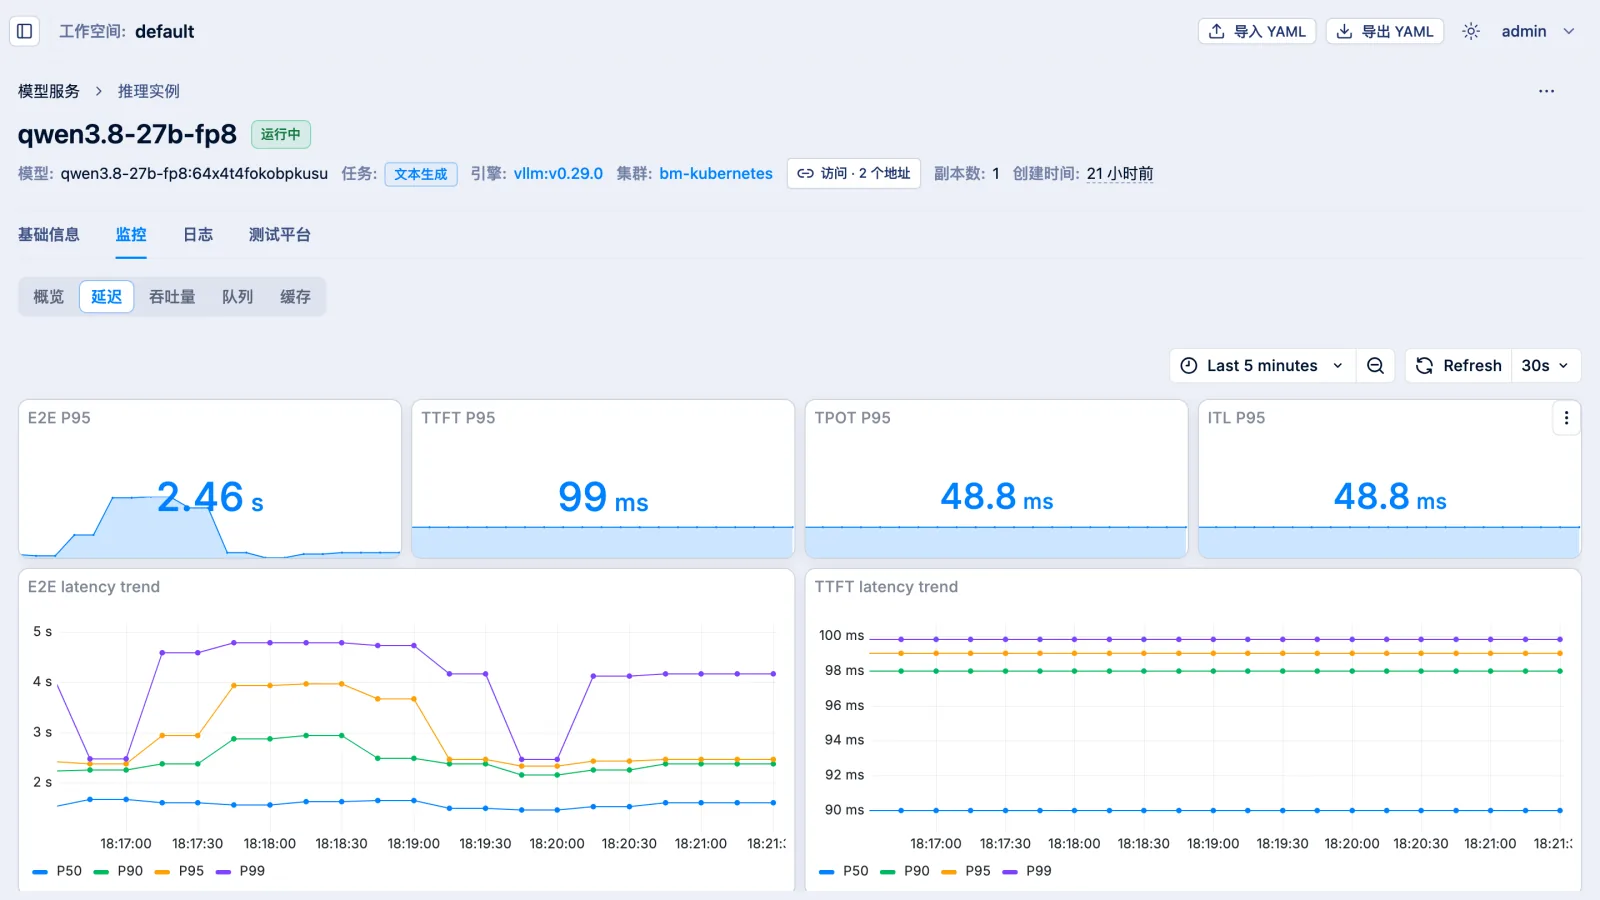
支持查看推理实例健康状态、实时日志、TTFT、TPOT、E2E 延迟、吞吐、队列和 KV Cache 使用情况,帮助平台团队快速定位模型服务性能瓶颈和运行异常。
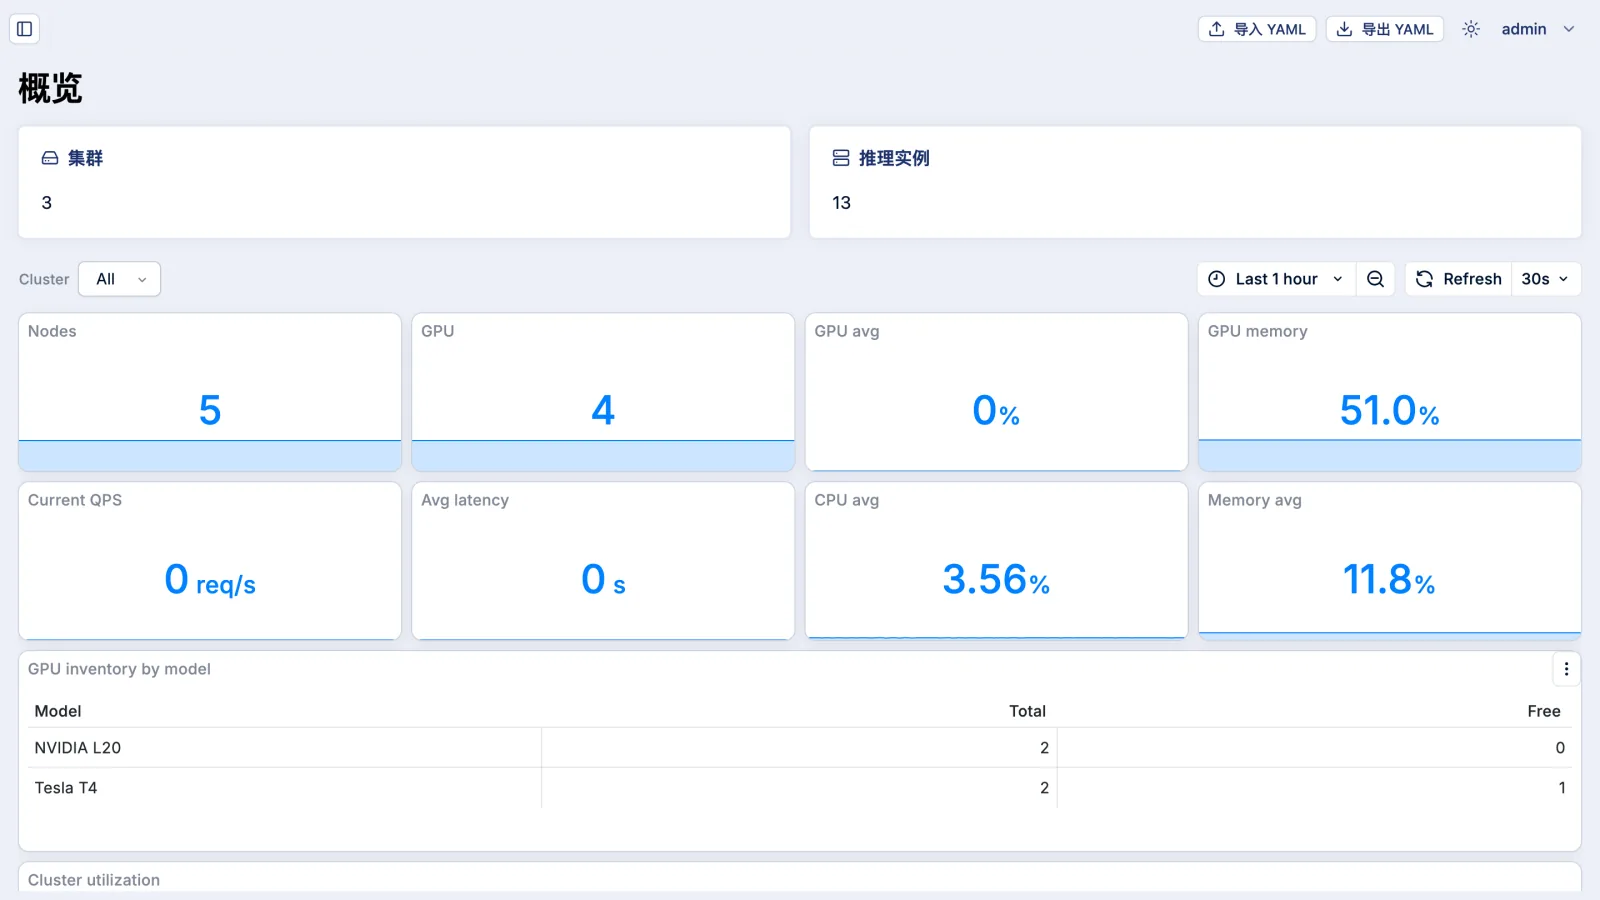
统一观测 GPU / NPU / CPU 等资源状态和使用情况,支持从节点、芯片、模型实例等维度了解资源占用。管理员可在统一视图中查看每个节点、每块 GPU / NPU 的使用情况,并基于实际负载进行资源规划、调度和优化。
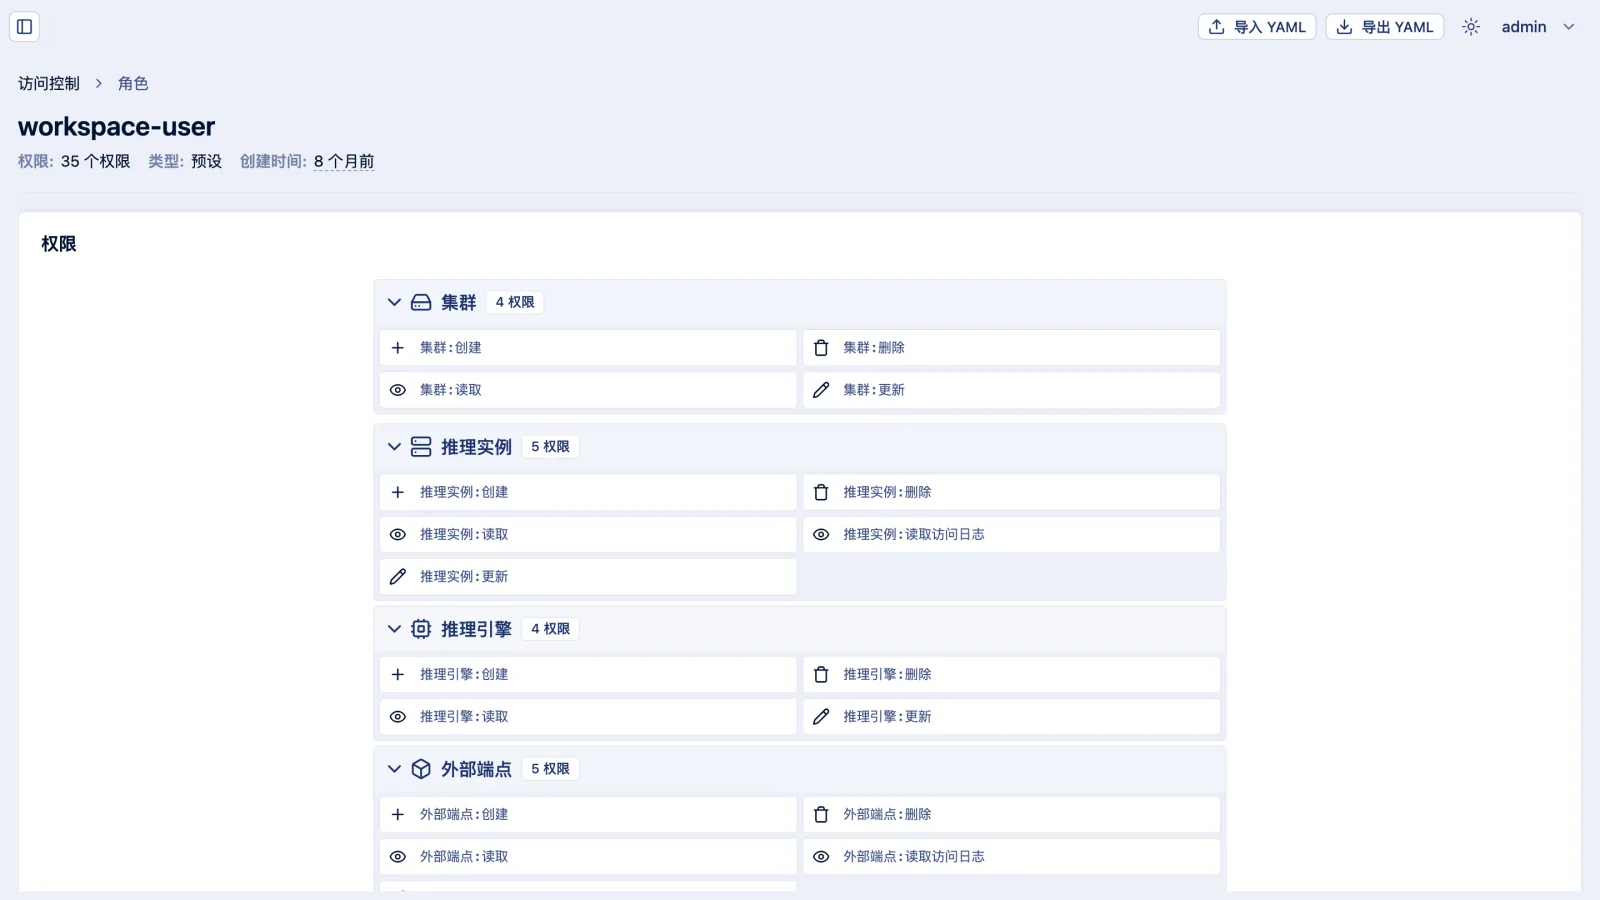
支持工作空间与 RBAC 权限控制,在集群、模型仓库、模型目录、镜像仓库、推理实例等关键资源上实现隔离和精细授权,满足多团队、多业务共享 AI 平台时的安全协作需求。
榫卯 AI 平台是榫卯企业云基础设施面向 AI 推理场景的重要组件,聚焦算力模型管理、模型治理和高性能推理,并可结合榫卯企业云平台提供的容器、存储、网络、安全和可观测能力协同,为企业构建生产级、高性能、可治理的模型推理基础设施。
为模型推理服务提供标准化运行时环境,支持 GPU 驱动管理,并结合高性能网络能力,保障推理实例稳定运行和高效调度。
为模型文件提供可共享、可管理的存储能力,减少重复存储和分发;同时可为 KV Cache 提供高性能、高容量的缓存与持久化支撑。
覆盖 GPU 硬件状态、容器运行状态、推理实例健康、模型资源消耗、调用日志、Token 用量和链路延迟等关键环节,形成全链路可观测能力,帮助企业快速定位问题、开展安全审计、评估服务性能并持续优化资源使用效率。

在榫卯企业云平台上统一支撑内部规范查询助手、翻译、运维等智能体应用,通过 AI 平台实现内部已有模型与自建模型的统一管理与治理。

基于榫卯 AI 平台实现算力和模型的统一管理,支撑各类 AI 应用。

基于榫卯企业云平台提供算力资源,支撑视频识别小模型,通过榫卯 AI 平台实现大语言模型的统一管理。